
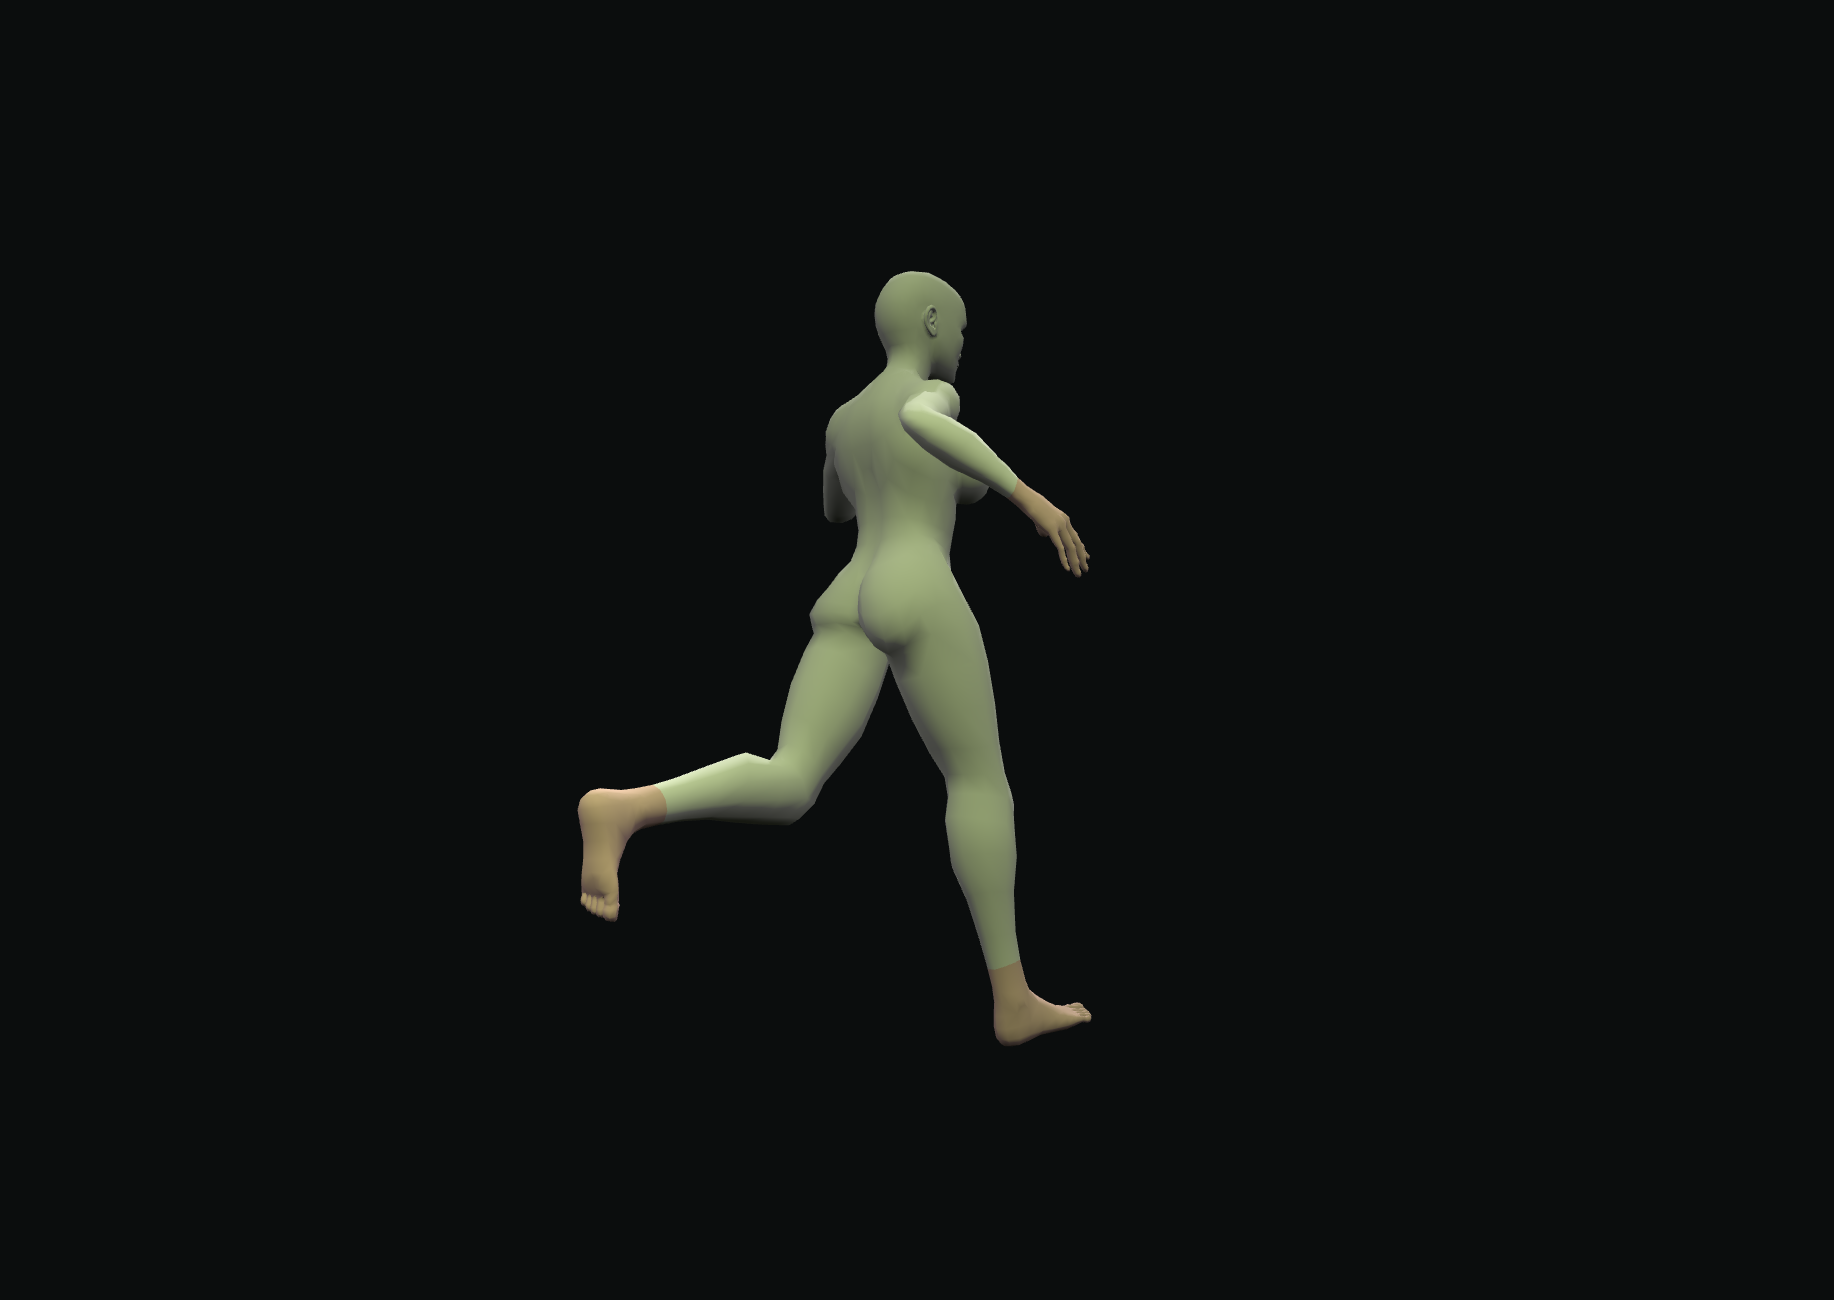
手动姿势控制
拖动身体手柄调整头部、躯干与四肢。塑造姿势时,连接的身体部位会跟随移动。
从姿势到图像
姿势参考为图像模型提供身体和构图的视觉指引。提示词则补充人物、环境与风格。
添加人物和道具,再应用姿势预设。细调身体控件和镜头,直到场景清楚易读。
3D 姿势编辑器选择 姿势生成图像 ,即可截取不含编辑手柄的可见场景。截图会作为参考附加到图像工作区。
场景 → 参考图在提示词中加入主体、服装、环境和光线。检查显示的积分费用,登录并生成图像,再根据结果进行调整。
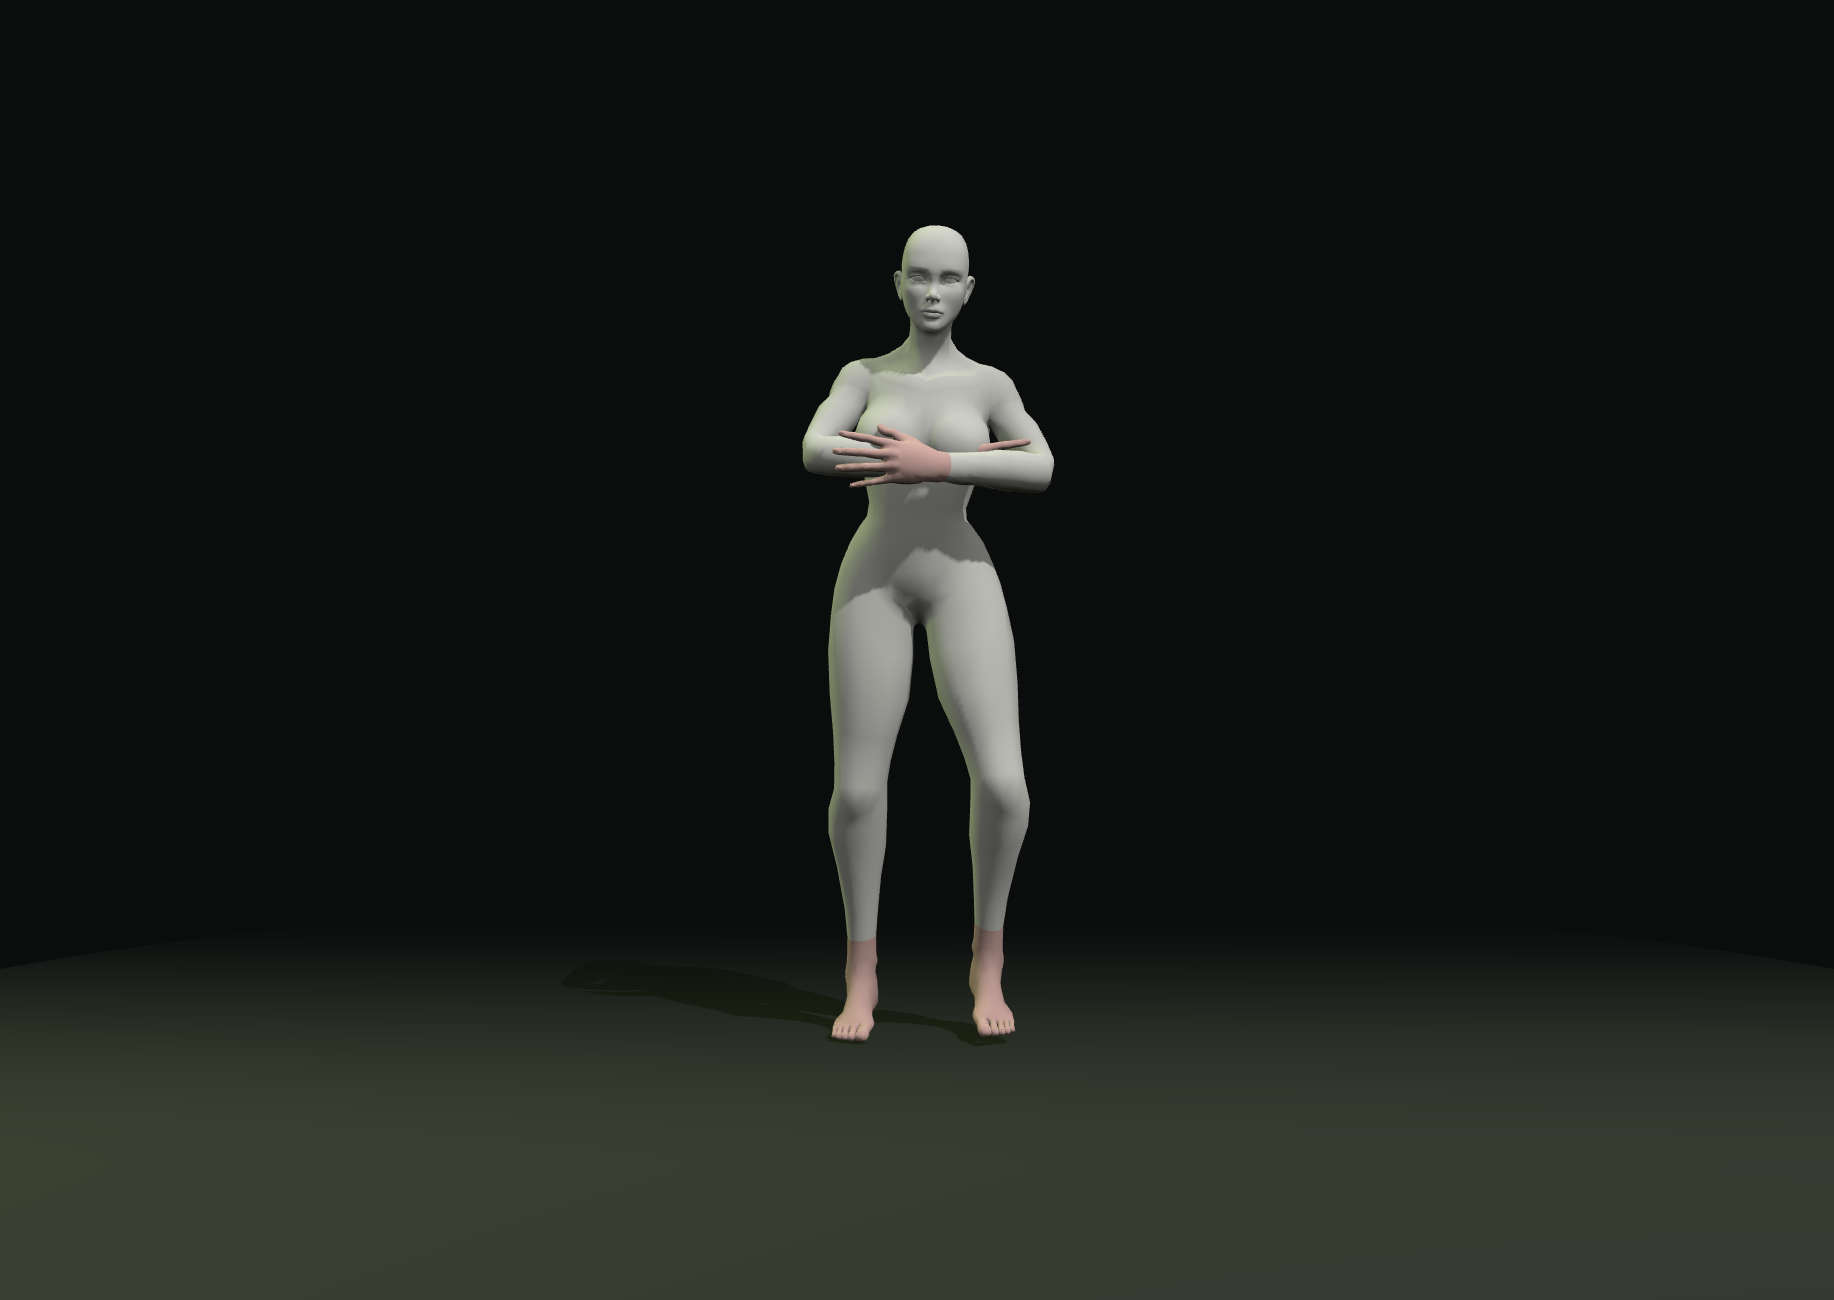
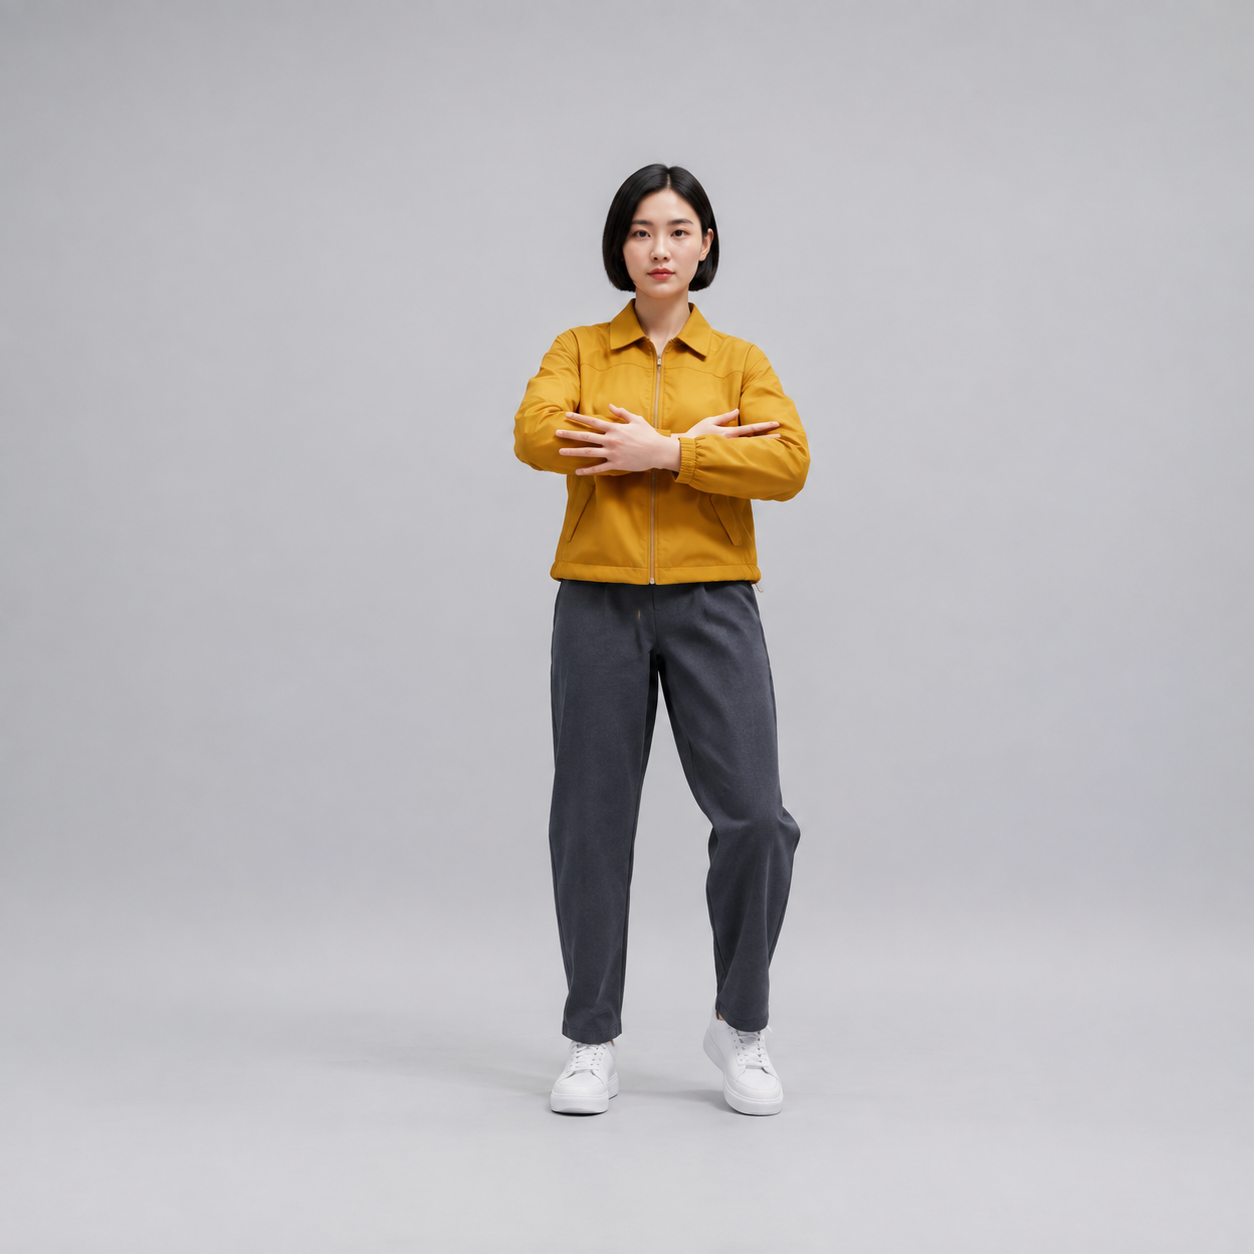
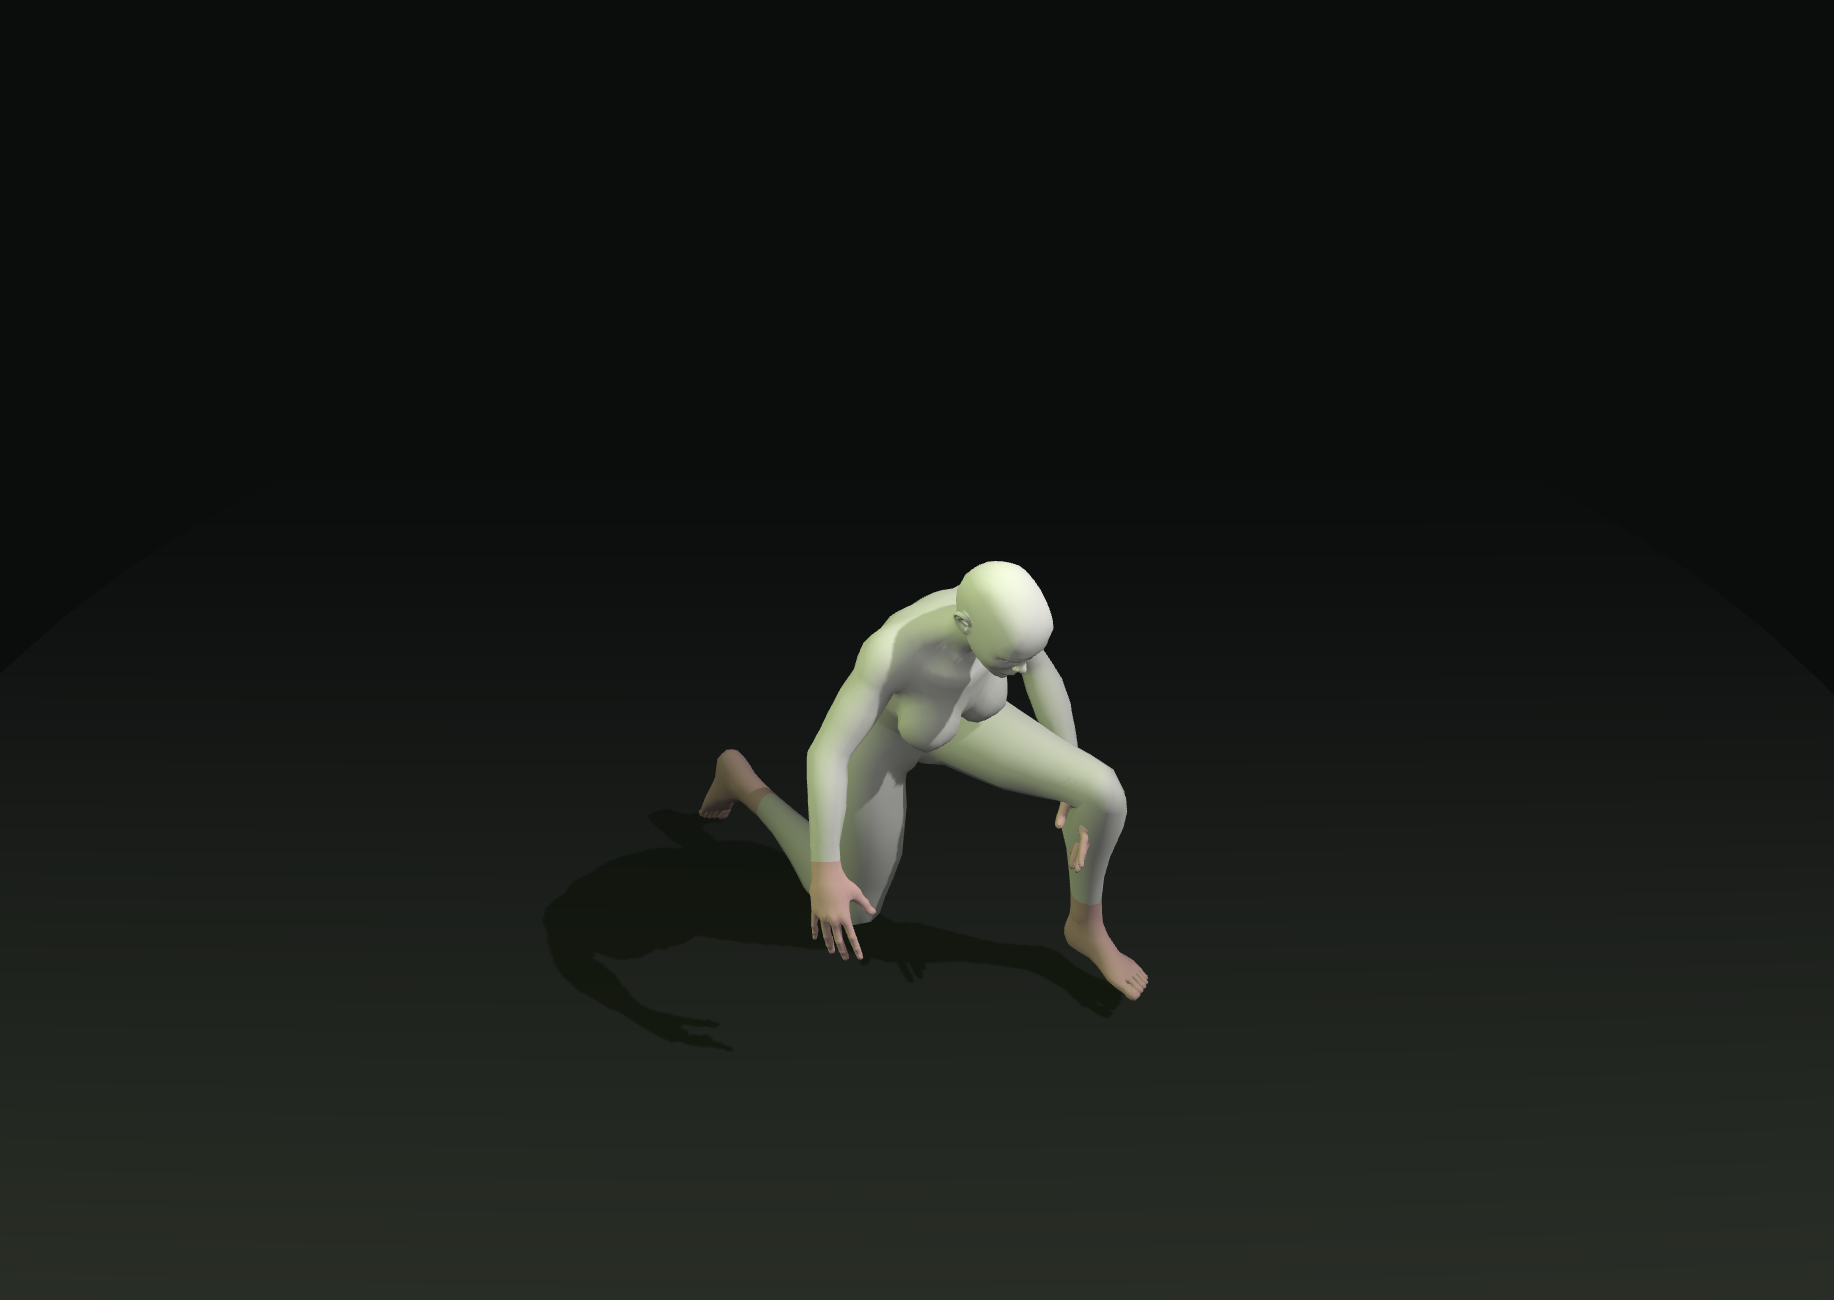
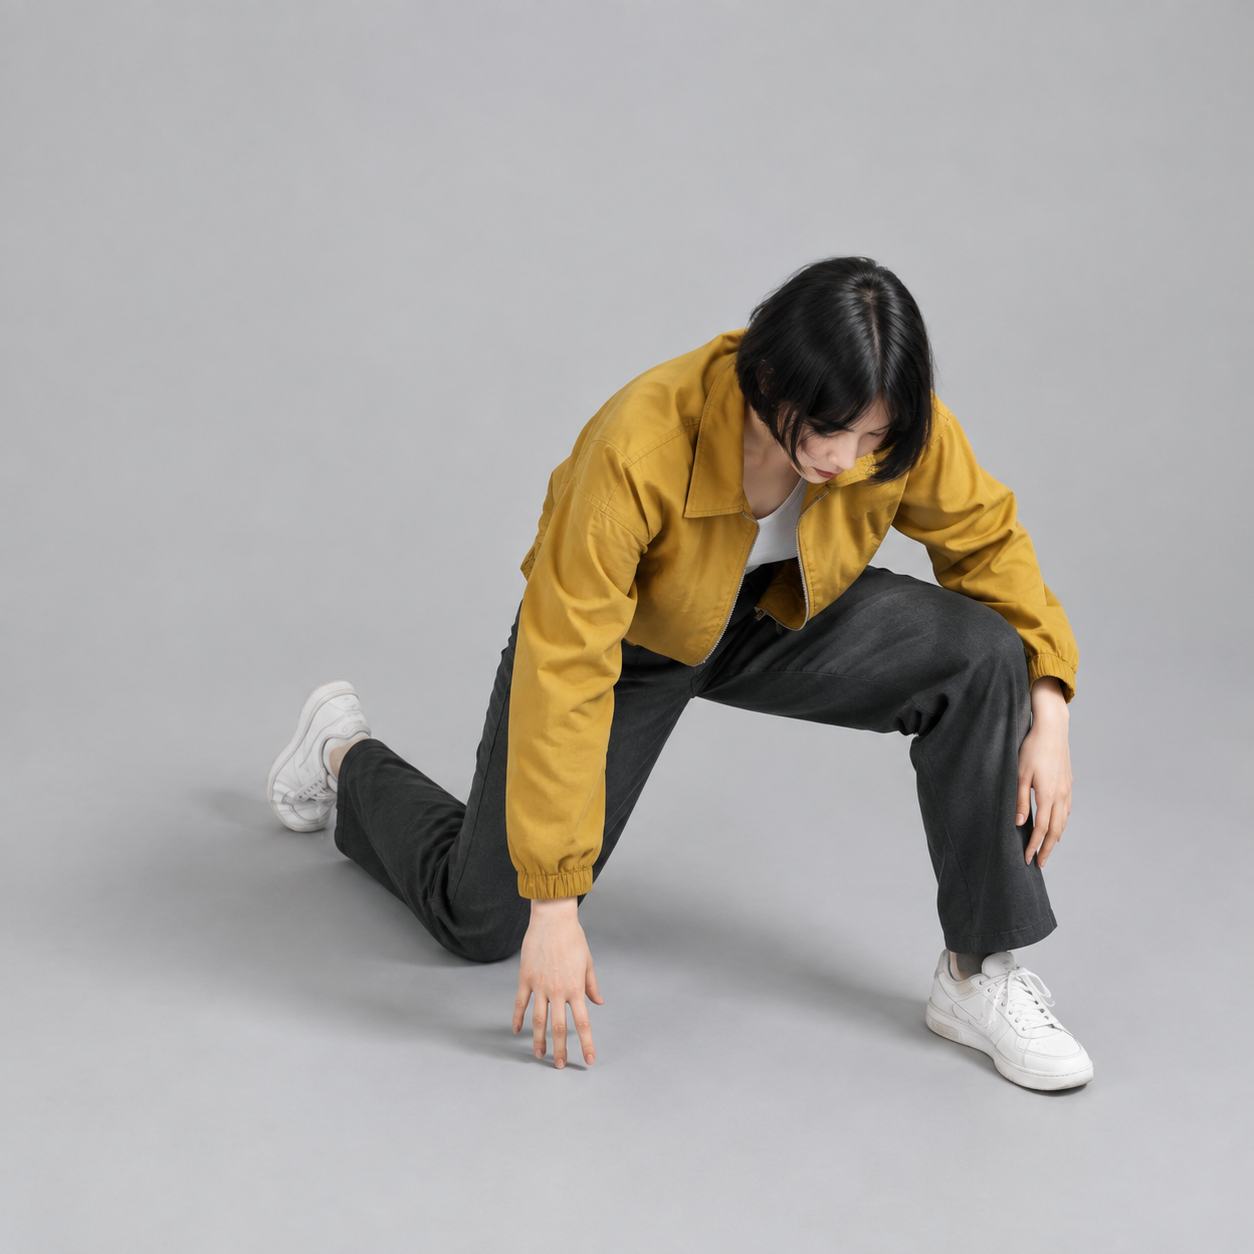
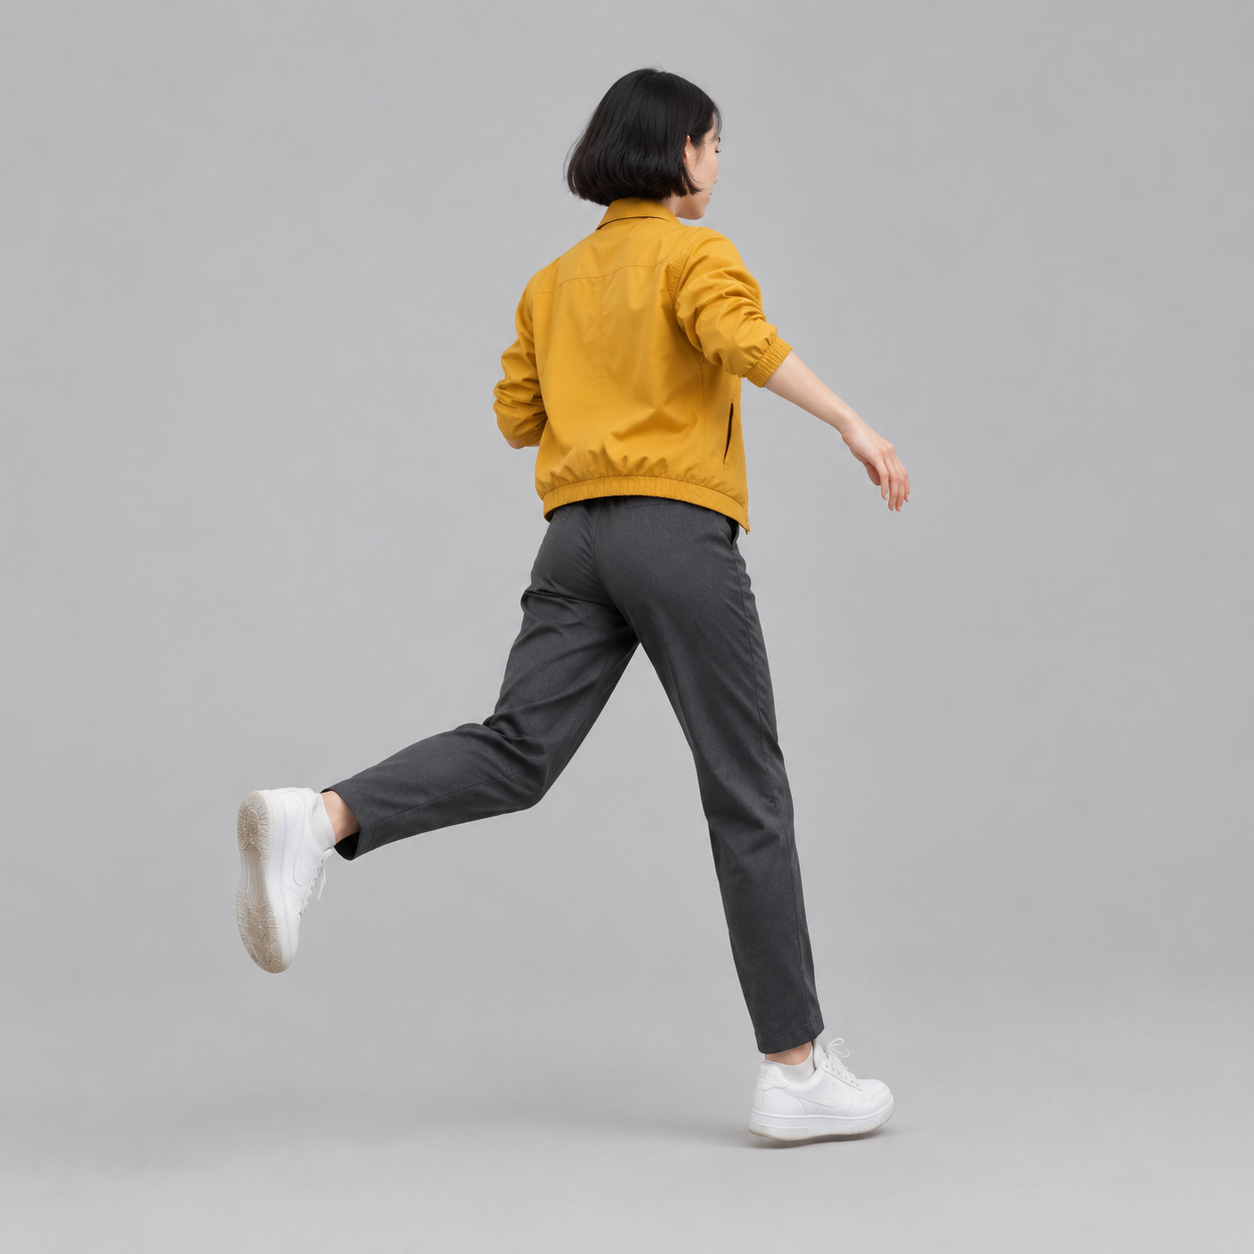
参考图+提示词 → 图像原创案例
对比摆好的场景和生成图像,探索镜头角度、身体位置与构图如何影响结果。
未经过修图的首次尝试。姿势、身体结构与构图可能与参考不同。 查看更多包含人物、动物与道具的案例 →
拖动身体手柄调整头部、躯干与四肢。塑造姿势时,连接的身体部位会跟随移动。
拖动空白区域环绕场景,滚动缩放。截图时的镜头视角会成为发送到图像生成器的参考。
将可见人物、道具与镜头视角发送到图像工作区。截图不包含编辑手柄,为提示词提供清晰参考。
在编辑器中尝试抱臂、跪姿或慢跑预设。用手柄细调,使用撤销和重做,或重置所选人偶。
实用的起点
人偶场景截图是视觉参考。图像模型会结合提示词理解它,因此结果的身体结构、姿势、镜头角度或位置可能有所差异。
从清楚的轮廓与四肢布局开始。每次生成后检查手、重叠肢体和身体比例。无法保证姿势完全匹配或身份保持一致。
AI 姿势生成器常见问题
Seedance 将手动 3D 姿势编辑器与参考引导图像生成结合起来。你先调整人偶与镜头,再在图像工作区附加截图并描述目标图像,模型会根据参考进行生成。
可以。打开编辑器、调整人偶与镜头、准备参考图即可,无需提交生成请求。图像生成是独立操作,需要登录和足够积分。
可以。将人物和动物加入同一个场景,选择各自调整姿势,并在周围安排道具。截取整个构图作为共同参考。浏览 可编辑姿势场景 ,选择起点。
无法保证完全匹配。参考会引导身体姿势和镜头构图,但模型可能重新理解身体结构、重叠和位置。人偶也无法确定人物身份。输出偏离目标时,继续优化参考与提示词。
不能。这套流程截取的是 3D 场景的渲染图像,不提供 OpenPose 骨架、关键点文件或 ControlNet 姿势图导出。
可以。根据姿势场景生成图像,再使用结果上的视频操作,将图像送入 图生视频工作区 作为参考。生成视频前描述想要的动作与运镜。